コーディングエージェントにMemPalaceを丸投げして作らせたが、実用に耐えうるものにするには古典的エンジニアリングが必要だった話
なぜ自分専用の記憶ストアが欲しかったのか
日常的にコーディングエージェントを使い倒している人なら、誰しも一度は「エージェントに永続的な記憶を持たせたい」と考えたことがあるはずです。 たとえばHermes Agentを使っていると、普段の対話の中でエージェントが自発的にAgent Skill(スキル)を生成し、繰り返し発生するワークフローをうまく処理できるように「自習」していく様子が見られます。この仕組み自体は素晴らしいのですが、私の開発環境はHermesだけで完結していません。用途に合わせてHermes、Antigravity、Reasonix、WorkBuddyを日常的に切り替えて使っています。
そこで真っ先に壁にぶつかりました。Hermesが自習で蓄積したスキルは、システムの標準的なユーザースコープ($HOME/.agents/skills)ではなく、Hermes自身のプライベートなストレージに保存されます。ワークスペースのルートにスキルを複製保存するルールを追加してみたものの、結局それはファイルのコピーに過ぎず、記憶が1つのツールの中に閉じ込められたままであることに変わりはありませんでした。これを機に何かを学びたいと思い、自作ツールしかないと思いました。
ちょうどその頃、映画『バイオハザード』でアリスを演じた女優(ミラ・ジョヴォヴィッチ)が「MemPalace」というオープンソースプロジェクトを公開したのを見かけました。その名前が妙に頭に残り、自分のワークステーション用にも同名の記憶システムを作ってみようと思い立ちました。彼女のリポジトリを覗いたりコードを真似したりしたわけではありません。名前が頭に残ったのは単なる偶然ですし、自分が求めていた機能は至ってシンプルだったため、自分だけでどこまで通用できるものが作れるか試したかったです。
もうひとつ、少し意地悪な実験意図もありました。当時世間で大騒ぎされていた「バイブコーディング(Vibe Coding)」のハイプ(誇大広告)を、実際に真に受けてみたらどうなるかを試したかったのです。「ソフトウェアアーキテクチャは死んだ」「自然言語が新しいコードだ」「LLMとおしゃべりするだけで本番システムが立ち上がる」と誰もが言っていました。正規のエンジニアリング規律を全部かなぐり捨てたとき、一体どこで破綻するのかを自分の目で確かめたかったのです。
私のWindows上の開発環境は、日々更新され続ける生きたワークスペースです。数ヶ月の作業を通じて、便利なスクリプト、リファクタリングの記録、アーキテクチャ決定記録(ADR)、そして現場特有の回避策がどんどん積み上がっていきます。コミュニティではこれをOpenClawで「ロブスターを飼育する」とか、「長期稼働するHermesプロファイルを育てる」と表現したりします。しかし、コンテキストウィンドウには上限があり、モデルのエンドポイントはリクエストごとにすべてを忘れます。記憶を持たないエージェントは、まったく同じミスを何度でも繰り返します。Windowsのファイルロック問題で同じように転び、リモートLinuxマシンのsystemdタイマー設定を同じようにミスし、バックグラウンドデーモンを同じように壊すのです。
私が求めていた要件は、突き詰めると4つだけでした:
- エージェント間の共通利用:Hermes、Antigravity、Reasonix、WorkBuddyが、全く同一のローカルストアを検索できること。
- プレーンテキストの所有権:ブラックボックスのデータベースやクラウドサービスではなく、ディスク上のMarkdownファイルこそを唯一の真実(Source of Truth)とすること。
- ミリ秒単位のCLI応答:タスク開始前の記憶検索はミリ秒単位で返るべきであり、数秒も待たされてはならない。
- 完全なローカルWindows実行:外部SaaSの契約も不要、外部ベクトルDBも不要、バックグラウンドで重たい常駐デーモンを動かさないこと。
浅はかな実験:エージェントに丸投げして作らせてみた
私はコーディングエージェントに、極めて大雑把なプロンプトを投げました。「このワークスペース用の永続記憶・検索ツールを作ってほしい。どのエージェントも作業前に過去の解決策を引けるようにしてくれ」と。スキーマ定義も、テストケースも、評価用ベンチマークも、品質ゲートも一切与えませんでした。完全にエージェント自身の判断に任せたのです。
ストレージに関しては、ベクトルデータベースを使わずにDuckDBを採用するよう指示しました。なぜかというと、DuckDBがおしゃれだと感じたからだけです。個人用の開発ワークステーションにとって、外部の専用ベクトルDBを動かすのは明らかなオーバーキルに思えたので、DuckDB単体で何とかなるでしょうと思っただけです。構想は単純です。私がMarkdownでメモを書き、エージェントがそれを MemPalace/memory.duckdb に同期する。あえて甘い発想でVibe Codingしてみて、どんなものが作り上げられるか、またその過程はどんなものなのかも感じてみたかったです。
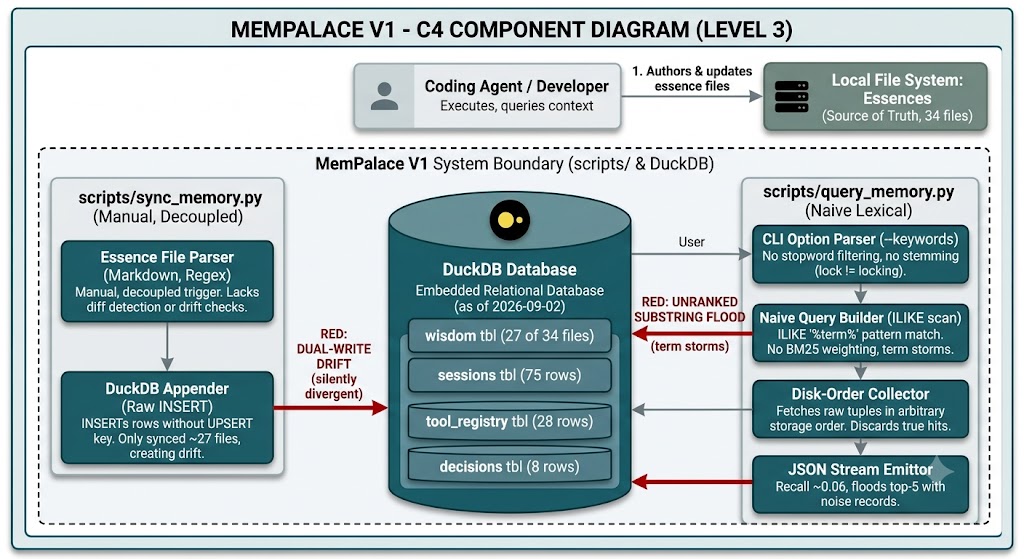
エージェントは何の異論も挟まず即座に賛同しました。「DuckDBは軽量で高速で、この用途に完璧にフィットする」と請け合い、ほんの数分のうちに2本の独立したPythonスクリプトを書き上げました。MarkdownをDuckDBにコピーする scripts/sync_memory.py と、それを検索する scripts/query_memory.py です。
スクリプトは初回実行からシンタックスエラーひとつなく完璧に動きました。ターミナル出力も綺麗にフォーマットされていました。データベースの設計も、線形代数の勉強もせず、半日足らずで動く記憶システムが手に入ったように思えました。
そして私は、それを日々の開発に投入しました。
V1の検死解剖:デジタル儀式と再現率0.06の現実
それからの数週間、エージェントたちはタスクに着手するたび律儀に query_memory.py を呼び出していました。ターミナルを流れるクエリログを眺めていると、エージェントたちが賢く学習しているような満足感がありました。
しかし実際のところ、検索結果はほぼ役に立っていませんでした。CLIは何も返さないか、あるいは全く関係のないメモを20件も画面にぶちまけるかのどちらかでした。私が何時間もかけてドキュメント化したはずのWindowsファイルロックの挙動に、エージェントたちは相変わらず何度も足を取られ続けました。作業前の記憶クエリは、完全に「デジタル儀式」へと成り下がっていたのです。トークンとCPU時間を無駄に消費するだけで、現場の役には何ひとつ立っていませんでした。
あるデバッグセッションの最中、すでにメモに記録してあった既知の罠にエージェントが再び突っ込んだとき、私は作業を止めて直接問い詰めました。
「今のMemPalaceって、セマンティック検索ができる状態なのか?」
エージェントの返答は、一言だけでした。
「いいえ(No)。」
私はリポジトリから一旦離れました。ローカルのコンテキストを一切持たないWeb版Geminiの新しいセッションを開き、ストレージエンジンと検索の基本原理について初歩から質問を投げかけました。
そこで真っ先に浮き彫りになったのは、初歩的なミスマッチでした。DuckDBは本質的にOLAP(オンライン分析処理)エンジンであるということです。数百万行の列指向スキャンや複雑な集計分析を行うために設計されています。一方、エージェントがタスク開始前に過去の知見を1件引くという処理は、完全に OLTP(オンライントランザクション処理) の世界です。せいぜい150件程度のドキュメントに対する、マイクロ秒単位のポイントルックアップと単一行の更新です。150件のローカルCLIインデックスにDuckDBを使うのは、向かいの家に手紙を届けるために巨大な貨物船をチャーターするようなものでした。最初からSQLiteを使うべきだったのです。
もうひとつの問題は、検索技術に対する私自身の知識不足でした。密ベクトル、埋め込み(Embedding)、コサイン距離といった言葉は、あまり首を突っ込みたくない機械学習の専門用語のように感じられていました。しかしソフトウェア工学の記事を読んでいたとき、Robert C. Martin(Uncle Bob)が振る舞い駆動開発(BDD)について書いているのを見かけました。そこからGherkin構文による仕様記述と受け入れテストの世界を知ることになったのです。
点と点が一気に繋がりました。信頼できる検索システムを作るのに、機械学習の学位なんて要らない。必要なのは古典的なソフトウェアエンジニアリングの規律だ。 ベクトルの数学を自力で導出する必要はありません。エージェントが安易な手抜きに逃げられないよう、自動実行可能な受け入れテストで外枠をカッチリ固定してやればいいだけだったのです。
改めてV1のコードベースを検死解剖してみると、エージェントが選んだ「近道」の酷さに苦笑いするしかありませんでした:
- 順位付けのない部分一致スキャン:「検索をつけて」と頼まれたエージェントは、最も手抜きなSQL
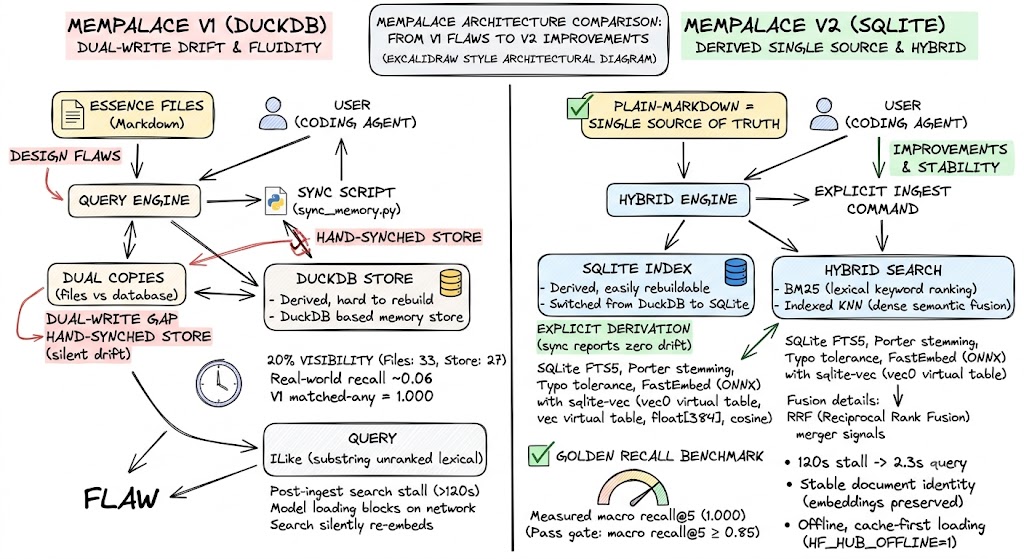
ILIKE '%<query>%'を書いただけでした。BM25スコアリングも、単語の境界認識も、ステミング(語幹抽出)もありません。"file lock"で検索してもハイフンがあるせいで"file-locking"にはヒットしません。ディスク上に解決策のメモがあるのに、"vmmem wslconfig"を検索してもヒットは0件。一方で"windows"のようなよくある単語で検索すると、ディスク上の保存順そのままに数十件ものメモが吐き出され、本当に必要な1件が埋もれてしまうのです。 - 二重書き込みによる静かな乖離:ディスク上のMarkdownファイルとDuckDB内のデータは完全にバラバラでした。手動で
sync_memory.pyを走らせない限り、データベースは更新されません。自動的な差分検知がないため、データベースは気づかないうちに時代遅れのゴミになっていました。 - 実効再現率0.06の惨状:実際の開発で使う20個のリアルなクエリでV1を測定してみたところ、DuckDBには実際のメモの20%しか同期されていませんでした(ディスク上に34ファイル以上あるのにDBには27行だけ)。しかもドキュメントが運良くDB内に存在していたとしても、稚拙な部分一致スキャンが正解を見つけられる確率は30%しかありませんでした。
MemPalace V1は、ワークスペースの知見の94%を見落としていました。制約なきバイブコーディングの真実とはこういうものです。コードは綺麗にコンパイルが通り、ターミナルの見た目は申し分なく、実際の現場ではほぼ完全に沈黙のうちに破綻しているのです。
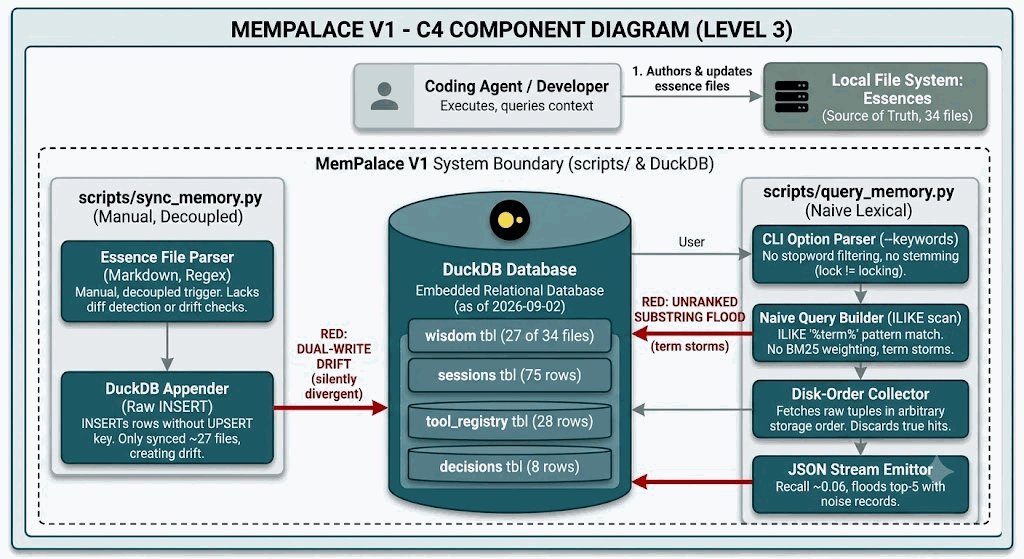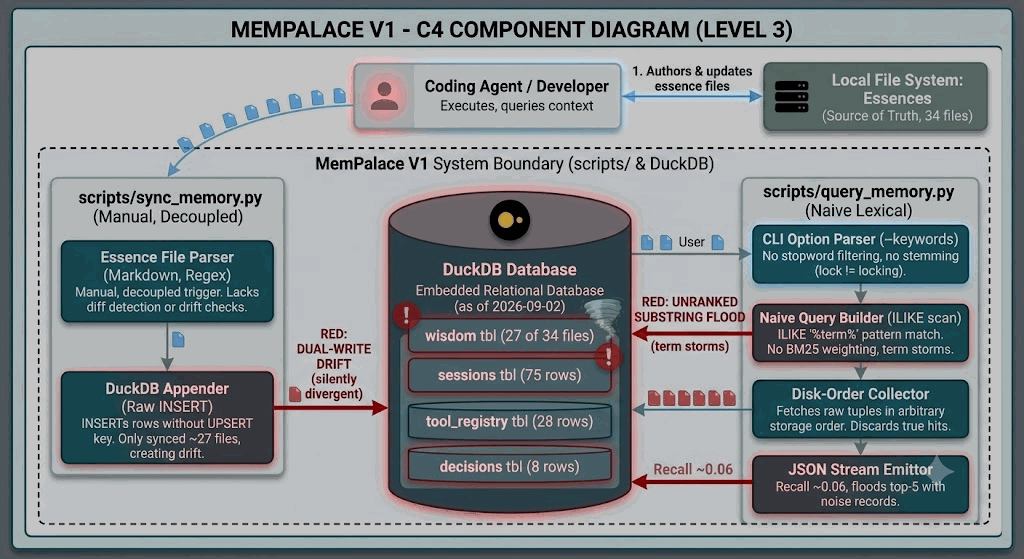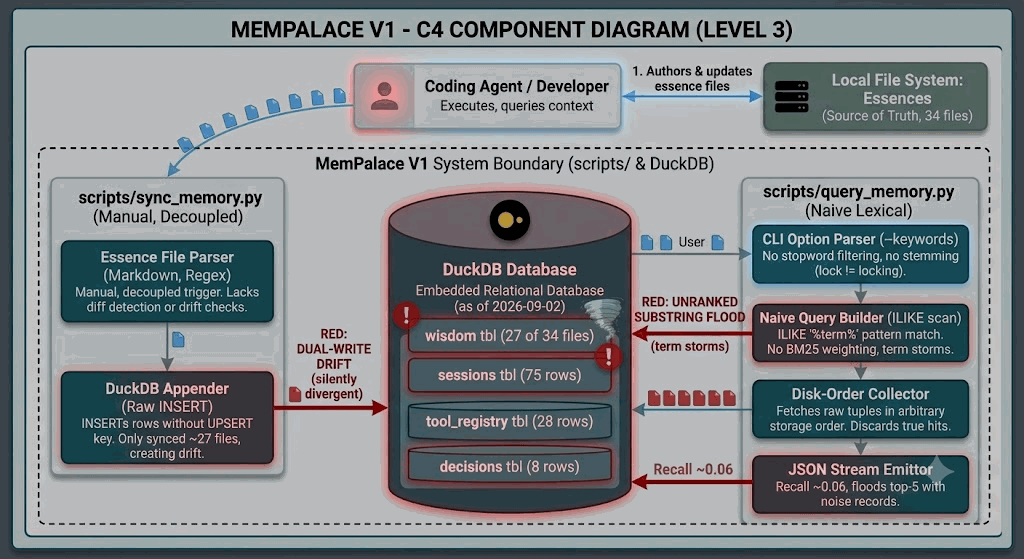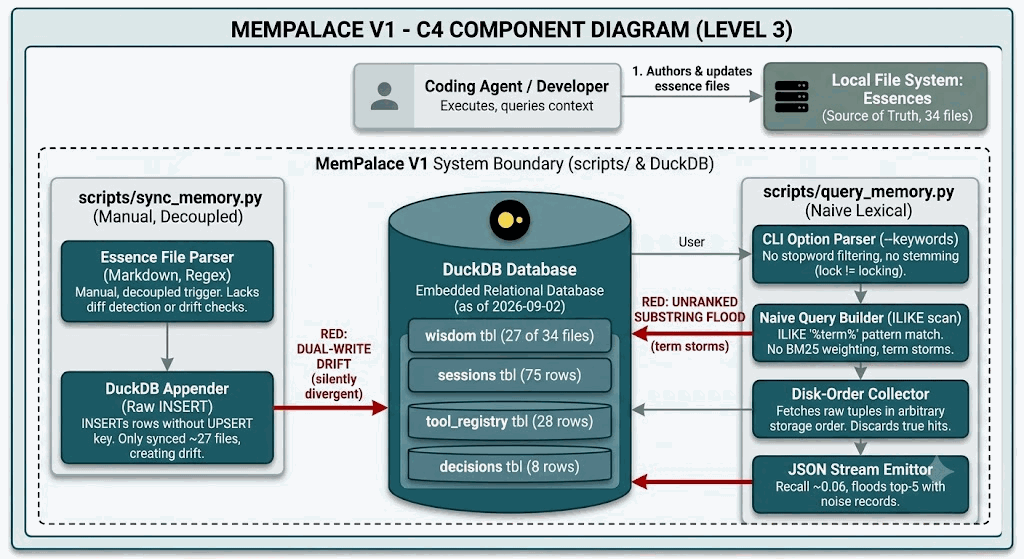
古典的エンジニアリングによるV2の再構築
この問題を解決するのに、Mem0、Zep、Lettaのようなクラウド記憶プラットフォームは不要でした。そうしたサービスは、ホスト型データベース、外部APIへの依存、そして遅くて挙動の定まらないLLM書き込みを持ち込みます。Windows上のローカルCLIワークフローにとって、それは別の面倒事を抱え直すだけに過ぎません。
私はコーディングエージェントとの付き合い方を根本から変えました。エージェントをアーキテクト(設計者)として扱うのをやめ、厳格なテストゲートのもとで作業する実装担当者として扱うことにしたのです。
1. コードより先にベンチマークを作る
検索コードを1行も書かせる前に、まず評価スイートであるGolden Recall Benchmark(tests/benchmark/)を作らせました。過去の実際のトラブルシューティングに基づき、20個のリアルな開発者クエリと、それぞれがヒットすべき正解Markdownファイルを定義しました。そして、Macro Recall@5が最低でも0.85以上、かつ0件ヒットのクエリがゼロであることを絶対条件に据えました。検索の良し悪しはもはや主観的な感想ではなく、合格か不合格かの客観的な数値になったのです。
2. Gherkin契約と2つのテストループ
エージェントが勝手な近道を選べないよう、Gherkin構文(tests/features/mempalace.feature)と pytest-bdd を用いて実行可能な仕様契約を書きました。エージェントは、DB初期化、ファイル取り込み(ingest)、BM25マッチング、ベクトルコサイン距離、差分突合といったシナリオを、Given・When・Then に沿って厳密に実装しなければなりませんでした。
テストは2つのループに分離しました:
- アウターループ:クリーンな一時ディレクトリ上で
python -m mempalaceをサブプロセスとして叩き、終了コード、引数、JSON出力を検証するCLIブラックボックステスト。 - インナーループ:ディスクアクセスを行わず、インメモリSQLite上でFTS5クエリ、ベクトル計算、フュージョンランキングを検証する超高速な単体テスト。
3. ファイルを唯一の真実とする
二重書き込みの乖離をアーキテクチャレベルで解消しました。ディスク上のMarkdownファイルこそが唯一の正本です。SQLiteデータベース(MemPalace/memory.sqlite)は、いつでも捨てて作り直せるキャッシュインデックスに過ぎません。DBを削除しても、mempalace ingest を一発走らせれば完全に再構築されます。専用の mempalace reconcile コマンドを使えば、ディスクとDBをいつでも照合でき、未取り込みのファイルがあれば即座に警告が出ます。
4. 枯れて実証された部品を組み合わせる
自前の検索アルゴリズムをでっち上げるのをやめ、実戦で検証済みの4つの標準部品を組み合わせました:
- ストレージ:Python標準ライブラリのSQLite。WALモードと
busy_timeoutを有効化し、高速な読み書きを担保。 - 語彙検索:SQLite FTS5仮想テーブルにBM25ランキングとPorterステミングを搭載。複数語クエリはデフォルトで厳格なAND一致を行い、ヒットが0件の場合のみランキング付きORにフォールバック。
- 稠密ベクトル検索:
fastembedを使い、BAAI/bge-small-en-v1.5(384次元)の埋め込みをローカル生成。ONNX Runtime上で動作するため、PyTorchもCUDAもGPUも一切不要。類似度はNumPyでベクトル化したコサイン関数で計算。 - ハイブリッドフュージョン:相互ランク融合(RRF, )により、壊れやすいスコア正規化を行わずにBM25順位とベクトル順位を統合:
20クエリのベンチマークにおいて、最適化したBM25単体でもRecall@5は0.925を記録しました。さらにRRFでベクトルと融合させたところ、ハイブリッド検索は満点の1.000 Recall@5を達成し、20個の評価クエリすべてで正解文書を確実に引き当てました。
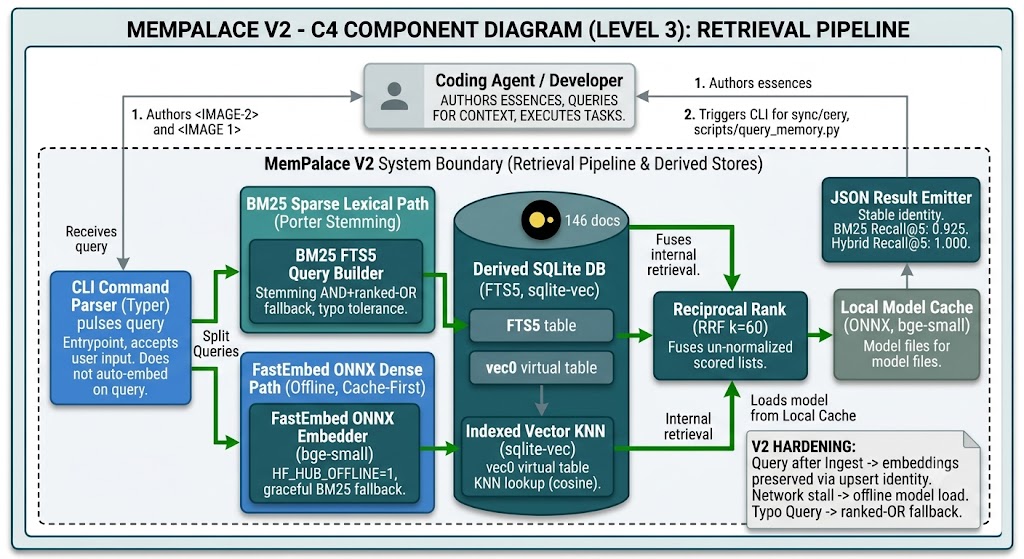
120秒フリーズの撲滅と運用の堅牢化
アーキテクチャが整い、単体テストがすべてパスしていても、実環境に持ち込むとすぐにボロが出ました。V2が動くようになった直後、重大な問題が発生しました。インデックスを更新する ingest を実行した直後に検索をかけると、CLIが2分以上完全にフリーズ(ハング)するのです。
実行ログをトレースしたところ、3つの不具合が連鎖していることがわかりました:
- 意図しないベクトルの巻き添え削除:
ingestがドキュメントを更新する際にsearch_docsの古い行を削除したところ、ON DELETE CASCADEルールによってdoc_vectors内の事前計算済みベクトルまで一緒に消し飛んでいた。 - 検索パスでのその場再Embedding:ユーザーが検索を実行した際、コードがベクトルの欠損を検知し、クエリ処理の最中に全146件のドキュメントをその場で再Embeddingしようとしていた。
- モデル読み込み時の通信待機:FastEmbedとHugging Face Hubが、モデルの初期化時にリモートのメタデータをネット経由で確認しにいっていた。低速回線や接続制限のある環境では、この通信チェックのせいで検索プロセスが無限に固まっていた。
この3つの原因に対し、4つの明確なルールを設けました:
- 安定したドキュメント複合キー:
(source_kind, source_ref)の複合キーでupsertする方式に変更。内容が変わっていないメモはDB内部IDを維持し、インデックス再作成時にもキャッシュ済みベクトルが破棄されないよう保護。 - フェイルファストな検索契約:検索コマンドの中では絶対にドキュメントのEmbedding計算を行わない。ベクトルが存在しない場合は即座にBM25語彙検索へとフォールバックして結果を即座に返し、ユーザーには別個に
mempalace embedを走らせるよう警告する。 - 完全なオフラインモード:ローカルにモデルファイルが存在する場合、エンジンは常に
HF_HUB_OFFLINE=1を強制設定し、外部への通信プローブを物理的に遮断する。 - 英語コーパスへの統一:ワークスペースに残っていた中国語混じりのメモ3件を標準英語に翻訳。コーパスを英語に純化することで、軽量な
bge-small-en-v1.5モデルでの言語間ベクトルのズレを解消。
この堅牢化を行った結果、インデックス作成直後の検索レイテンシは120秒超から約2.3秒へと激減しました。テストスイートはBDDシナリオ、単体テスト、CLI検証を合わせて273件オールグリーンに拡大し、ruff および pyright strict の型チェックもすべてパスしています。
| 指標 / シナリオ | v1 DuckDB 部分一致 | v2 初版ハイブリッド | v2 堅牢化済み本番版 |
|---|---|---|---|
| ストレージエンジン | DuckDB(OLAPのミスマッチ) | SQLite(派生インデックス) | SQLite + FTS5 + NumPy Cosine |
| ドキュメント可視性 | 20%(二重書き込みの乖離) | 100%(ファイルから直接派生) | 100%(reconcileで常時監査) |
| Macro Recall@5 | ~0.06(重複欠陥による崩壊) | 0.925 (BM25) / 1.000 (RRF) | 1.000(検証済みゴールデンセット) |
| インデックス直後の検索時間 | 一瞬(ただし94%を見落とし) | >120秒(その場再計算でスタック) | ~2.3秒(完全オフライン) |
| テストスイート | 0件 | 20件のゴールデンクエリ | 273件のテスト + BDD仕様契約 |
バイブコーディングが真に役立つ領域
バイブコーディングにはもちろん使い所がありますが、その範囲はごく狭いものです。骨組みの作成、使い捨ての小さなスクリプト、定型コードの自動補完といった用途に限られます。LLMを野放しにすると、プロンプトを「解いたように見せる」ための最も手抜きな近道を本能的に選んでしまいます。期限切れの腐敗したデータベースに対して順位付けのない部分一致スキャンをあてがい、「セマンティック検索です」と平然と言ってのけるのです。スクリプトの終了コードは0であり、ターミナルの出力は一見動いているように見えるからです。
古典的なソフトウェアエンジニアリングは、コーディングエージェントの敵ではありません。エージェントをまともに使える道具にするための、不可欠な手綱なのです。
エージェントを自律的な思考主体として崇めるのをやめ、厳格なテストで囲い込んだ実装担当者として扱い始めた瞬間、関係性は劇的に好転しました。Gherkin契約、実際の受け入れベンチマーク、厳格な型定義、そしてインデックス作成と検索の明確な分離を与えることで、エージェントは私が手でタイプするよりも遥かに速く、実用に耐えうる堅牢なコードを組み上げてくれました。
もし自分自身のエージェント用記憶ツールや開発環境の構築に取り組むなら、以下の経験則が参考になるはずです:
- 検索コードに手をつける前に、実際のクエリ20件と正解文書を集めてベンチマークを作ること。
- Markdownファイルこそを唯一の真実とし、データベースはいつでも捨てて作り直せるキャッシュとして扱うこと。
- 重厚な外部ベクトルSaaSを無理に持ち込まず、SQLite、FTS5、ローカルONNX埋め込みといった堅牢なローカル部品を信じること。
- 検索パスは完全な読み取り専用・オフラインに保ち、クエリの最中に計算や通信を行わないこと。
- BDD契約を受け入れゲートとし、エージェントが手抜きで誤魔化す余地をなくして本物のエンジニアリングを強いること。
コードとリポジトリ
V2が日々の開発で安定して動くようになった後、ワークスペース内に散らばっていたスクリプト群を整理し、単体のオープンソースライブラリとしてパッケージ化してGitHubに公開しました:
もし複数のコーディングエージェントを併用していて記憶の共有に頭を抱えている方や、実際のプロジェクトでGherkin契約や再現率ベンチマークがどう書かれているか興味がある方は、ぜひ覗いてみてください。Python標準のSQLiteとfastembedだけで完全オフライン動作し、273件のテストと20クエリの黄金評価セットもすべてそのまま収録しています。