我让 Coding Agent 自己写了 MemPalace,却不得不靠经典工程学才让它真正可用
为什么我想做一套自己的记忆工具
天天重度用 Coding Agent 的人,多半都琢磨过给它们加一套持久化记忆。 以 Hermes Agent 为例,你在日常对话里就能看到它动态“自学”生成各种 Agent Skill,用来更顺手地处理重复工作流。这个机制挺有意思,但我手头并不是只有 Hermes 一个工具。根据不同的活,我经常在 Hermes、Antigravity、Reasonix 和 WorkBuddy 之间来回切。
问题很快就来了:Hermes 自学沉淀的 Skill,默认都放在它自己私有的数据目录里,根本没写到系统标准的用户目录($HOME/.agents/skills)。即使我给它配了规则,让它自学时顺便把 Skill 复制一份到工作区根目录,也只是解决了文件备份,记忆依然锁在Hermes自己的harness中,别的 Agent 根本读不到。
恰好那段时间,《生化危机》电影里演爱丽丝的女演员开源了一个叫 “MemPalace” 的项目。这个名字挺好记,我便决定借用过来,在自己的工作站上也搞一套。我没去看她的仓库代码,名字只是个巧合;而且我想要的功能很接地气,特意不看现成实现,也是想尝试下单靠自己能做成什么样的东西,以及体验这个开发过程本身也是一件很有意义的事情。
此外我还有一个略带审视的想法:我想亲自试一把现在被吹上天的“氛围感编程”(Vibe Coding)。当时满网都在喊“软件架构已死、自然语言就是代码、只要跟 LLM 随便聊聊就能上线”。我倒要看看,把正规工程规范全扔了,到底会在哪里翻车。
我在 Windows 上的开发环境是一个持续演进的工作区。几个月下来,里面堆满了辅助脚本、代码重构记录、架构决策(ADR)和各种特定环境的踩坑经验。社区里常把这种感觉叫作在 OpenClaw 里“养龙虾”,或者“培育一个长期运行的 Hermes Profile”。但当上下文窗口用满、模型端点每次调用都是无状态的时候,没有记忆的 Agent 就会一遍遍犯低级错误:反复掉进 Windows 文件锁的坑、在远程 Linux 机器上写出错误的 systemd timer、或者反复配错后台服务。
梳理下来,我的诉求其实就四条:
- 跨 Agent 通用:Hermes、Antigravity、Reasonix 和 WorkBuddy 都能读取同一份本地记忆。
- 纯文本归属权:磁盘上的 Markdown 文件是唯一正本,而不是藏在黑盒数据库或云端服务里。
- 毫秒级 CLI 响应:任务开始前查记忆必须飞快,绝不能卡上好几秒。
- 纯本地 Windows 运行:零云端依赖、不用买向量 SaaS、也不用在后台挂沉重的数据库服务。
朴素的尝试:全盘甩给 Agent 自由发挥
我给 Coding Agent 下了一个极其宽松的 Prompt:给当前工作区写一个持久化记忆与搜索工具,让任何 Agent 在干活前都能查到以前的解决方案。我没有给任何数据模型、没有测试用例、没有评测基准,也没有设任何质量门禁。完全让它自己决定怎么做。
关于存储,我特意让它避开向量数据库,直接用 DuckDB。当时网上大火的 Agent 记忆项目动辄拉进 ChromaDB、搞出复杂的“翼(Wings)”和“宫殿(Palaces)”多层架构,依赖多得吓人。对于单台本地开发机来说,跑个专用向量数据库纯属杀鸡用牛刀。DuckDB 看起来清爽得多:现成的 MCP Server 很容易接,Python 里直接 uv add duckdb 就能用进程内 SQL 查询,不用起后台进程,我也一直想顺手试一把它的性能。逻辑很简单:我手写 Markdown 笔记,Agent 写脚本把它们同步进 MemPalace/memory.duckdb。当然,这是我刻意地一厢情愿地决定使用DuckDB。
Agent 几乎是一秒同意。它向我保证 DuckDB 极其轻量、速度极快、完全契合这个需求。几分钟内,它就交出了两个独立的 Python 脚本:负责把 Markdown 拷进 DuckDB 的 scripts/sync_memory.py,以及负责查询的 scripts/query_memory.py。
脚本一次跑通,零语法报错,终端输出也格式化得干干净净。整个过程不到一个下午,不用设计数据库表结构,不用碰向量数学,我似乎真的一路 Vibe Code 搞出了一个能用的 Agent 记忆系统。
接着我就把它放进了日常工作流。
V1 尸检:数字仪式与 0.06 的真实召回率
接下来的几周,每个 Agent 开工前都会老老实实调用 query_memory.py 查一遍记忆。看着终端里刷刷滚过的查询日志,我心里还挺受用,觉得它们终于有长期记忆了。
但真用起来,搜索结果基本就是个摆设。命令行要么什么都查不到,要么一下子甩出二十条毫无关联的笔记。Agent 依然会在我早就记录过的 Windows 文件锁 Bug 上反复摔跤。任务开始前的记忆查询彻底成了一场数字仪式:白白烧 Token 和 CPU 时间,给不出一点真正有用的上下文。
直到有一次,Agent 又在踩一个我明明详细写过解决方法的坑,我实在忍不住了,直接问它:
“现在的 MemPalace 到底能不能做语义搜索?”
Agent 给了我干脆利落的一个回复:
“不能。”
我决定从当前仓库的上下文里跳出来。我打开了一个全新的 Web 版 Gemini 独立对话,在完全不给当前项目代码的前提下,从头请教存储引擎和搜索底层的基本原理。
第一个问题后知后觉地浮出了水面:DuckDB 本质上是个 OLAP 引擎。它是为了在几百万行数据上做列式扫描和分析聚合而设计的。而 Agent 在开工前查一条过去的经验,完全是个 OLTP 场景:在大概 150 篇短文档里做微秒级的单点读取和单行写入。拿 DuckDB 来跑一个 150 条记录的本地 CLI 索引,简直是用远洋货轮去马路对面送快递。SQLite 从第一天起就是最合适的工具。
第二个问题是我自己在检索技术上的认知盲区。稠密向量、Embedding、余弦距离,之前在我眼里都像是不想深究的机器学习术语。但后来读技术文章时,我看到了 Uncle Bob Martin 讲行为驱动开发(BDD)的博客,顺着摸到了 Gherkin 规格契约和验收测试。
思路一下子通了:要搞出一套靠谱的检索,根本不需要去考个机器学习学位;你需要的是经典软件工程的纪律。 我不需要从头推导向量数学,我只需要用能自动执行的验收契约把 Agent 框死,不给它偷奸耍滑的余地。
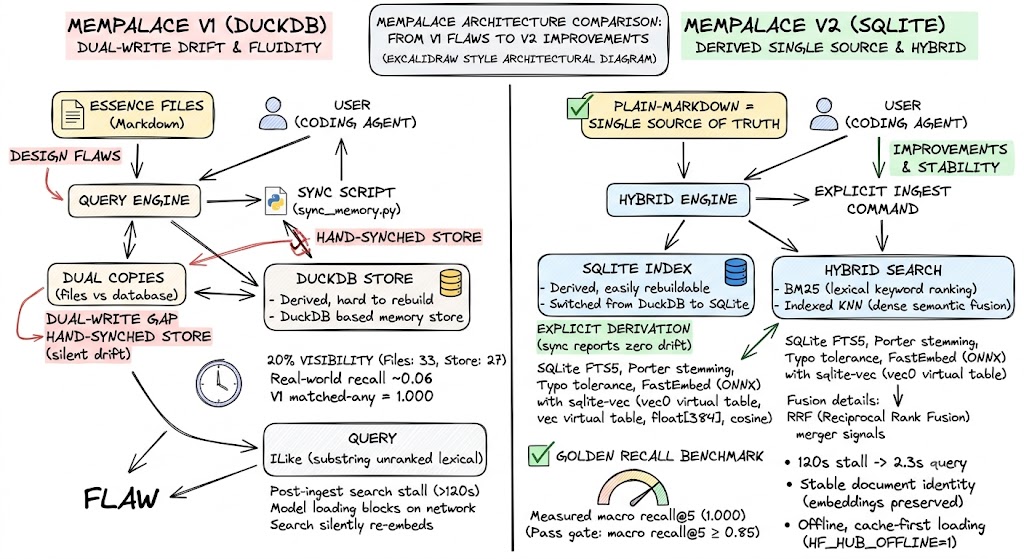
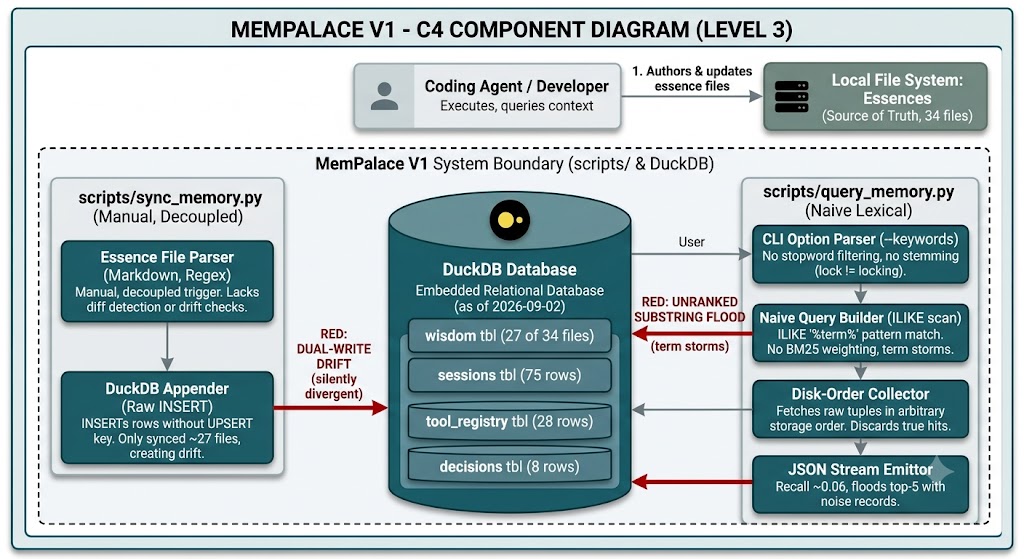
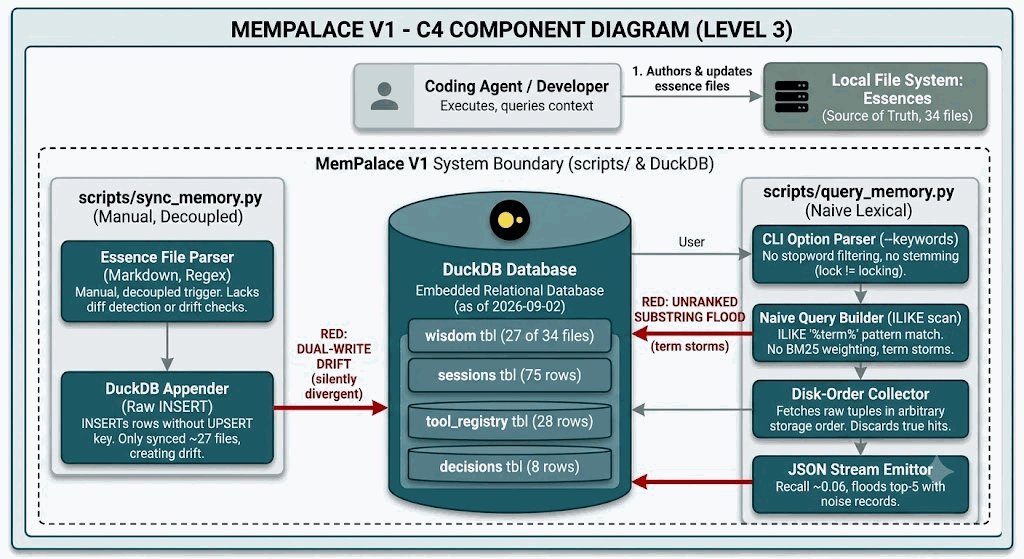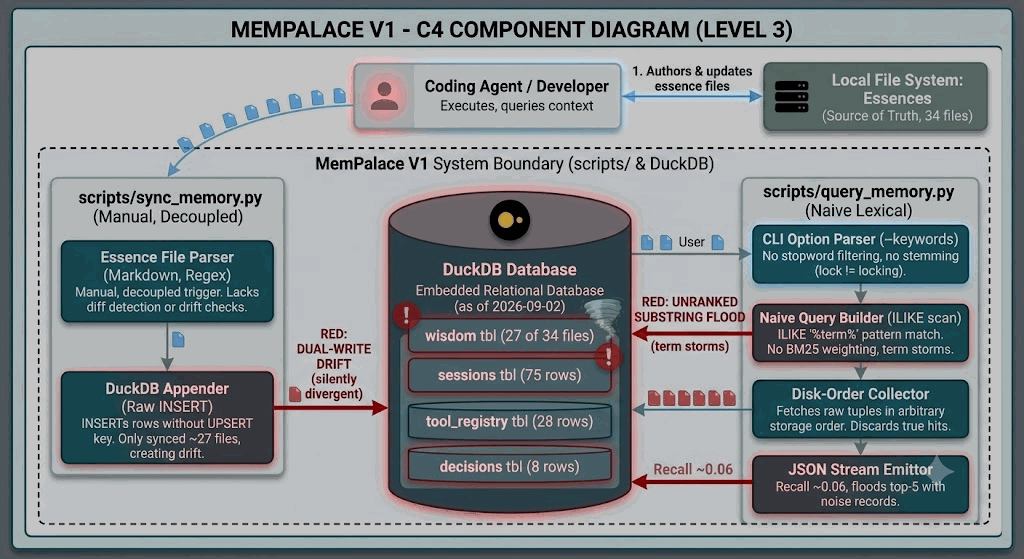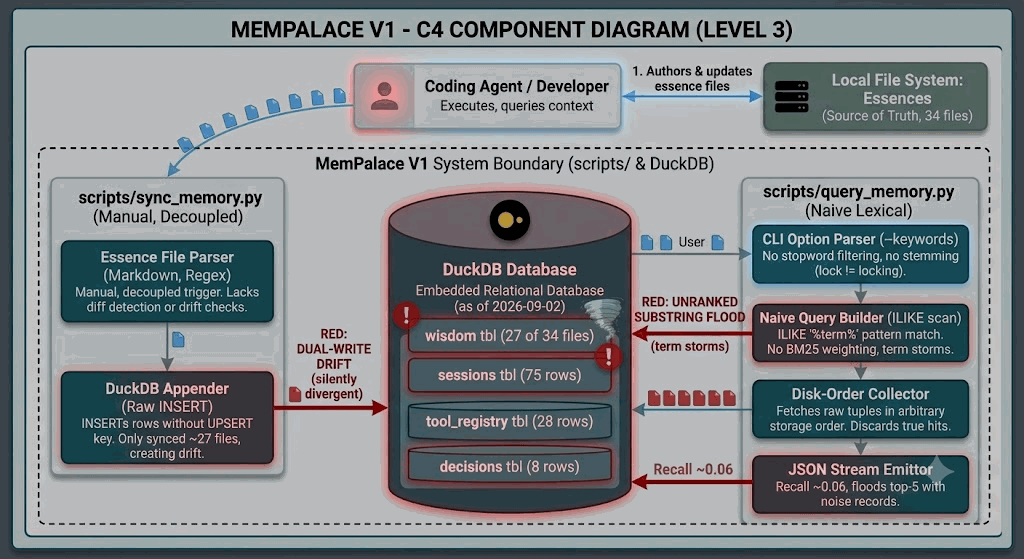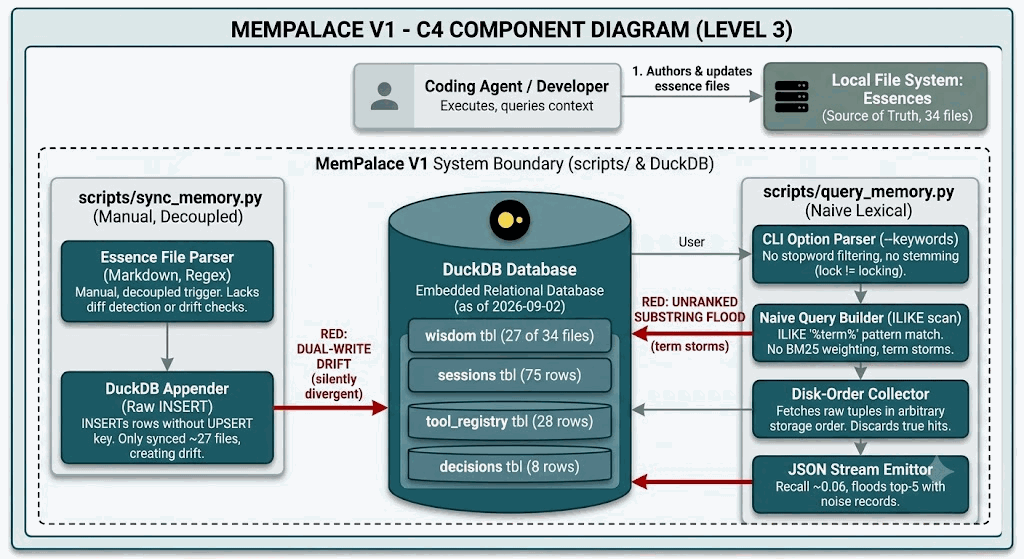
回过头去扒 V1 的代码,Agent 抄近道的痕迹简直让人哭笑不得:
- 毫无排序的子串硬扫:让它“加搜索”,它就写了一条最懒的 SQL
ILIKE '%<query>%'。没有 BM25 排序,没有分词,没有词干提取(Stemming)。搜"file lock"根本找不到带连字符的"file-locking";磁盘上有写好的笔记,搜"vmmem wslconfig"却返回 0 条;搜"windows"这种高频词,DuckDB 会按物理磁盘上的顺序倒出几十篇笔记,把真正有用的那条压在最底下。 - 双写导致的静默脱节:磁盘上的 Markdown 和 DuckDB 里的数据各过各的。只有我手动跑
sync_memory.py,数据库才会更新。没有任何自动比对机制,数据库在不知不觉中早就严重过时了。 - 0.06 的真实有效召回率:当我终于拿 20 个真实的日常开发 Query 去测 V1 时,DuckDB 里实际上只收录了 20% 的笔记(数据库里 27 条记录,磁盘上其实有 34+ 篇)。哪怕那篇文档刚好在数据库里,简陋的子串匹配也只有 30% 的概率能碰对。
MemPalace V1 漏掉了工作区里 94% 的核心知识。这就是毫无工程约束搞 Vibe Coding 的真实结果:代码跑得通、终端演示漂亮、但只要一上真活就全盘抓瞎。
用经典工程学重构 V2
要解决这些问题,根本不需要搬出 Mem0、Zep 或 Letta 这类云端记忆平台。那些方案带来了托管数据库、外部 API 依赖,以及慢吞吞且结果不确定的 LLM 写入。对于本地 Windows 上的 CLI 流程来说,纯属拆东墙补西墙。
我改变了和 Coding Agent 的合作方式。我不再把它当成架构师,而是把它当成必须在严格测试门禁下干活的初级开发。
1. 代码未动,评测基准先行
在写一行搜索代码之前,我让 Agent 先建好评测套件:黄金召回率基准(Golden Recall Benchmark)(在 tests/benchmark/ 目录下)。我们梳理了过去真实排查 Bug 时搜过的 20 个 Query,并给每个 Query 标定了应该召回哪些 Markdown 文件。我定死了一条硬指标:Macro Recall@5 必须达到 0.85 以上,且不允许有任何一条 Query 返回空。搜索质量不再是主观感觉,而是一个必须通过的客观数字。
2. Gherkin 契约与双层测试闭环
为了防止 Agent 再次自作主张抄近道,我们用 Gherkin 语法写了可执行的规格契约(tests/features/mempalace.feature),配合 pytest-bdd 执行。Agent 必须一步步实现规范好的 Given、When、Then 场景,覆盖数据库初始化、文件 Ingestion、BM25 匹配、向量余弦距离计算和差异对齐。
测试拆成两条闭环:
- 外环:子进程 CLI 黑盒测试,在干净的临时目录里运行
python -m mempalace,校验返回码、参数和 JSON 输出。 - 内环:极速的内存级 SQLite 单元测试,直接在内存里校验 FTS5 查询、向量数学和混合排序逻辑,不产生磁盘读写。
3. 文件作为唯一法定真理
我们从架构层面掐死了双写脱节的问题:磁盘上的 Markdown 文件是唯一的法定真理。SQLite 数据库(MemPalace/memory.sqlite)只是一个可随时丢弃重建的中间索引。删掉数据库,跑一遍 mempalace ingest 就能完全复原。配套的 mempalace reconcile 命令随时拿磁盘比对数据库,一旦发现哪个文件漏了没进索引,立刻报警。
4. 选用极度成熟的基础组件
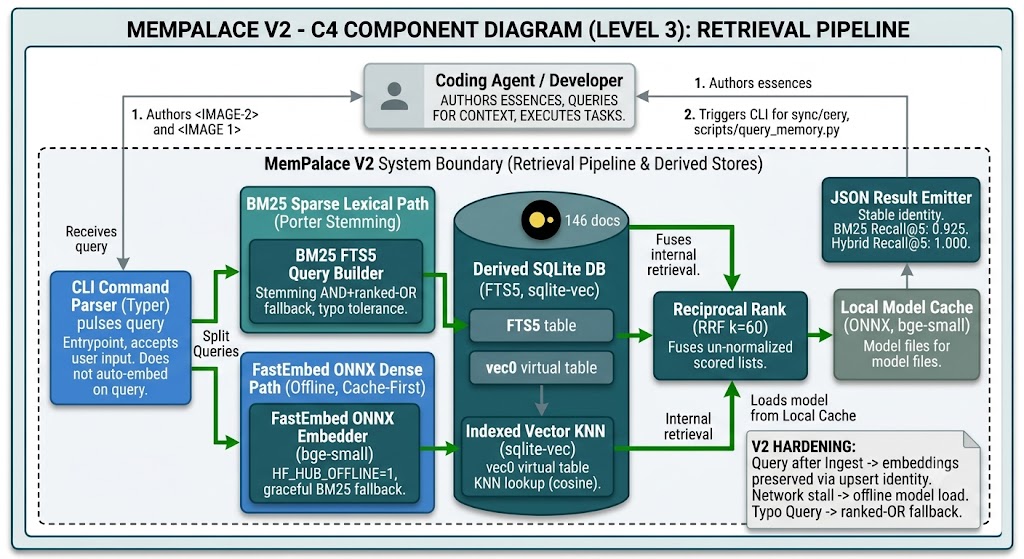
摒弃自制算法,直接把四个成熟原件拼在一起:
- 存储:Python 内置的 SQLite,开启 WAL 模式和
busy_timeout,轻松支撑低延迟的读写。 - 词法搜索:SQLite FTS5 配合 BM25 评分和 Porter 英文词干提取。多关键词默认走严格的 AND 匹配,只有在零命中时才降级为带排序的 OR。
- 稠密向量搜索:用
fastembed跑BAAI/bge-small-en-v1.5模型(384 维向量),底层依赖 ONNX Runtime。不需要装 PyTorch,不用配 CUDA,普通 CPU 就能飞速推理。向量相似度用 NumPy 向量化算余弦距离。 - 混合重排融合:通过倒数排名融合(RRF, )把词法排名和向量排名合二为一,免去脆弱的分数归一化:
在 20 个测试 Query 的基准集上,单靠优化后的 BM25 就能达到 0.925 的 Recall@5。加上向量经 RRF 融合后,整套混合管线打出了 1.000 的满分 Recall@5,所有测试用例全部精准命中。
解决 120 秒假死:工程加固细节
即便架构合理、单测全绿,一放进真实开发环境还是遇到了意想不到的深坑。V2 刚跑通时,我们发现一个致命故障:刚跑完 ingest 重建索引,紧接着敲搜索命令,整个 CLI 会卡死两分多钟。
排查调用链路后,我们发现了三个串在一起的坑:
- 级联外键误伤向量:
ingest重新导入文档时会先清掉search_docs里的旧记录,结果ON DELETE CASCADE规则静默把doc_vectors里预先算好的向量全部删了个精光。 - 在查询主路径上临时重算 Embedding:用户敲搜索命令时,代码发现向量没了,竟然现场开始在查询进程里把全部 146 篇文档逐个重新做 Embedding。
- 模型加载时偷偷联网:FastEmbed 和 Hugging Face Hub 在初始化模型时,默认会尝试走网络去检查远端元数据。在弱网或有网络限制的环境下,这次网络探活会把查询进程直接挂起。
针对这三处缺陷,我们立下了四条死规矩:
- 稳定的文档复合主键:统一用
(source_kind, source_ref)复合主键。内容没变的笔记在重新 ingest 时保留原来的主键,保护其缓存的向量不被清空。 - 搜索路径严禁重算(Fail-fast):搜索命令只做只读查询,绝不在热路径上现场算向量。如果缺少向量,立刻自动降级到纯 BM25 词法模式并秒出结果,同时提醒用户去单独跑
mempalace embed。 - 彻底强制离线:只要本地有模型权重文件,直接在环境里注入
HF_HUB_OFFLINE=1,物理切断对外网络探针。 - 语料标准化纯英文:把工作区里早期遗留的 3 篇中英混杂笔记全部翻成标准英文。纯英文语料完全杜绝了小模型跨语言 Embedding 带来的向量漂移。
这一通加固下来,建完索引后的搜索耗时从 120 秒以上断崖式压到了约 2.3 秒。测试套件增加到了 273 项全绿,覆盖 BDD 场景、底层单元测试和黑盒 CLI 测试,并严苛通过了 ruff 和 pyright strict 静态检查。
| 指标 / 场景对比 | v1 DuckDB 子串硬扫 | v2 早期混合版本 | v2 加固生产版本 |
|---|---|---|---|
| 底层存储 | DuckDB (OLAP 不匹配) | SQLite (派生索引) | SQLite + FTS5 + NumPy Cosine |
| 文档可见性 | 20% (双写脱节) | 100% (由文件派生) | 100% (reconcile 持续审计) |
| Macro Recall@5 | ~0.06 (双重缺陷相乘) | 0.925 (BM25) / 1.000 (RRF) | 1.000 (黄金基准全中) |
| 建索引后首查耗时 | 瞬时 (但漏掉 94% 笔记) | >120s (现场重算卡死) | ~2.3 秒 (纯离线) |
| 自动化测试 | 0 项 | 20 组 Golden Benchmark | 273 项测试 + BDD 契约 |
Vibe Coding 到底适合做什么
Vibe Coding 当然有价值,但它的适用场景其实很窄:搭脚手架、写一次性的小辅助脚本、或者快速补全模板语法。如果你放任 LLM 自流,它永远会本能地选择最省力、表面上看起来对的实现路径。它会毫无心理负担地在一个发霉落后的数据库上套个无序的子串扫描并告诉你这是“语义搜索”,因为反正脚本运行 exit code 是 0,终端打印得也有模有样。
经典软件工程并不是 Coding Agent 的敌人,而是真正能让它们发挥用处的绳索与鞍辔。
当我不再把 Agent 当作无所不能的智囊、而是把它当作身处严格测试门槛内的执行者时,整个合作状态完全变了。有了 Gherkin 契约、真实验收基准、严密的类型定义以及存储与计算的清晰分离,它敲出可靠工程代码的速度比我纯手写快得多。
如果你也在给自己的 Agent 写记忆工具或工作区套件,不妨参考这几条经验:
- 动手写搜索前,先列出 20 个真实的 Query 和期望召回的文件,把基准立住。
- Markdown 文件才是唯一真理,数据库只当随时能扔掉重建的缓存。
- 优先用成熟的本地原生组件(SQLite、FTS5、本地 ONNX 向量),别动辄把笨重的外部向量云服务往个人环境里塞。
- 搜索路径保持只读和纯离线,绝不能在查数据的时候现场跑计算或探网络。
- 拿 BDD 契约当红线,逼 Agent 老老实实解决工程边界问题,不给它留任何投机取巧的缝隙。
开源代码仓库
在 V2 彻底稳定并融入我的日常开发之后,我把原本散落在工作区里的临时脚本抽离出来,整理成了一个独立的开源 Python 项目:
如果你也经常在不同 Coding Agent 之间切换、饱受记忆割裂和重复踩坑的困扰,或者单纯想看看 Gherkin 契约与召回率基准测试在真实代码库里是怎么落地的,欢迎直接翻看代码。项目纯本地离线运行,依赖仅有标准 SQLite 和 fastembed,仓库里完整包含了全部 273 项测试用例以及那套 20 个 Query 的黄金评测集。